50 ejemplos
Muy pocos datos para aprender.
GanaSin capas83,1 % de acierto frente al 78,7 % de la red.
Reportaje · Inteligencia artificial
Es machine learning hecho con redes neuronales de muchas capas, que aprenden solas qué mirar en los datos. Lo comprobamos con cuatro modelos, y también el caso en que el clásico gana.
Capítulo 1 · La respuesta
El deep learning es machine learning hecho con redes neuronales de muchas capas, que aprenden por su cuenta qué mirar en los datos.
En español se llama aprendizaje profundo. Es una rama del machine learning, que a su vez es una rama de la inteligencia artificial. IBM lo define como «un subconjunto de machine learning impulsado por redes neuronales» y fija el listón en modelos con al menos cuatro capas1.
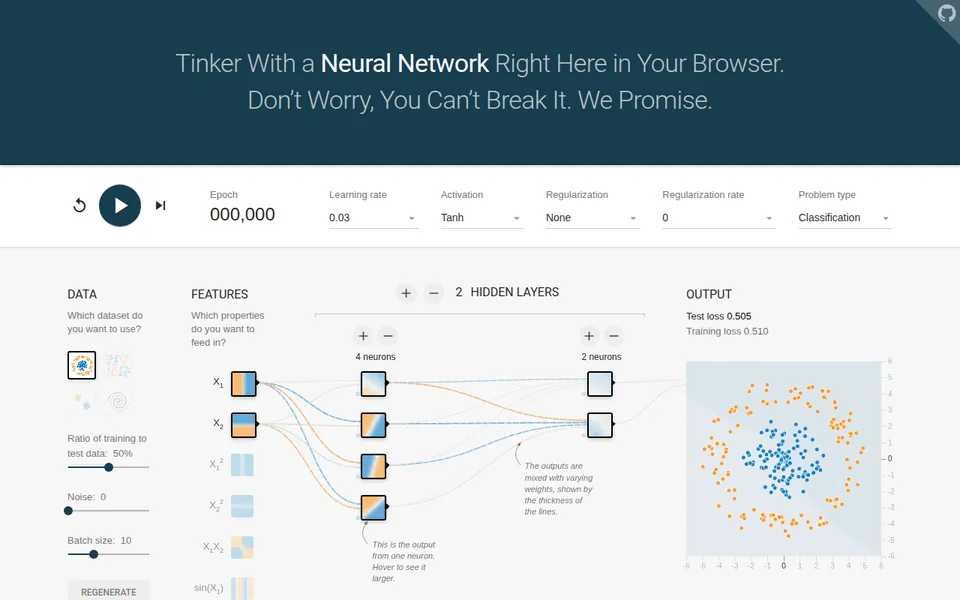
Una red neuronal es un programa formado por operaciones pequeñas, desde unas pocas hasta millones, las «neuronas», ordenadas en capas. Cada capa recibe números de la anterior, los combina y pasa el resultado a la siguiente. La palabra «profundo» solo dice que hay muchas capas ocultas entre la entrada y la salida. No dice nada de que la máquina entienda el mundo.
Capítulo 2 · Cómo funciona
En el machine learning clásico una persona decide qué datos importan. En el deep learning esa elección la hacen las propias capas: según IBM, son las capas ocultas las que permiten aprender «características jerárquicas complejas de los datos»1. Con una foto, el proceso es este:
Una foto no es más que una tabla de números: el brillo de cada píxel. La red no sabe qué es una oreja o una rueda.
Bordes y manchas de color. No es que alguien se lo pidiera: es lo que les sirvió para acertar.
Con bordes se forman esquinas y curvas; con curvas, formas. Cada capa trabaja sobre lo que encontró la anterior.
«Gato, con un 92 % de seguridad», por ejemplo. Al principio la respuesta es casi al azar.
Se mide cuánto falló frente a la respuesta correcta y se ajustan un poco los pesos de todas las conexiones, de la última capa hacia atrás. Esa corrección se llama retropropagación.
Con cada vuelta acierta algo más. Por eso necesita muchos ejemplos y mucha potencia de cálculo, normalmente tarjetas gráficas.
Capítulo 3 · Una prueba hecha para este artículo
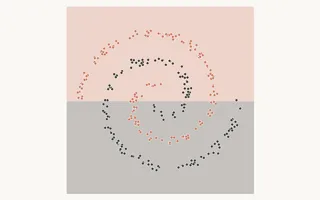
Entrenamos cuatro modelos en el servidor de este blog con el mismo problema: separar dos espirales de puntos entrelazadas. 700 puntos para aprender y 300 que no habían visto nunca para examinarlos2.
Cada punto pertenece a una de dos espirales que se enroscan una dentro de la otra. Para separarlas no basta con trazar una línea: hay que seguir la curva. Es un problema de juguete, pero recuerda a lo que pasa con fotos o con voz, donde la frontera entre «sí» y «no» tampoco es recta.
Un modelo clásico de machine learning, con 3 parámetros. Solo sabe trazar una recta, así que parte el plano por la mitad y acierta el 64,3 % de los puntos nuevos. Entrenó en 0,01 segundos.
Ya es una red neuronal, con 33 parámetros, pero se queda casi igual. Repetida con otras dos semillas (otro punto de partida al azar), se quedó en el 69,0 % y el 65,3 %. Una capa estrecha no bastó para seguir las curvas.
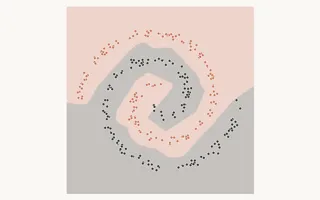
Tres capas de 32 neuronas, 2.241 parámetros y 392 pasadas por los datos (1,67 segundos). Falla 2 puntos de cada 300, y con otras dos semillas repite el 99,3 %. Contando la capa de salida son cuatro capas que aprenden: el listón de IBM.
¿La red de tres capas acierta por tener capas o por ser más grande? Para saberlo, una red de una sola capa con los mismos 2.241 parámetros. También aprende la espiral, con un 99,0 %, pero no se detuvo hasta las 1.038 pasadas y 10,14 segundos. Con las tres semillas, entre 2,6 y 3 veces más pasadas que la de tres capas.
Capítulo 4 · Lo que dibuja cada modelo
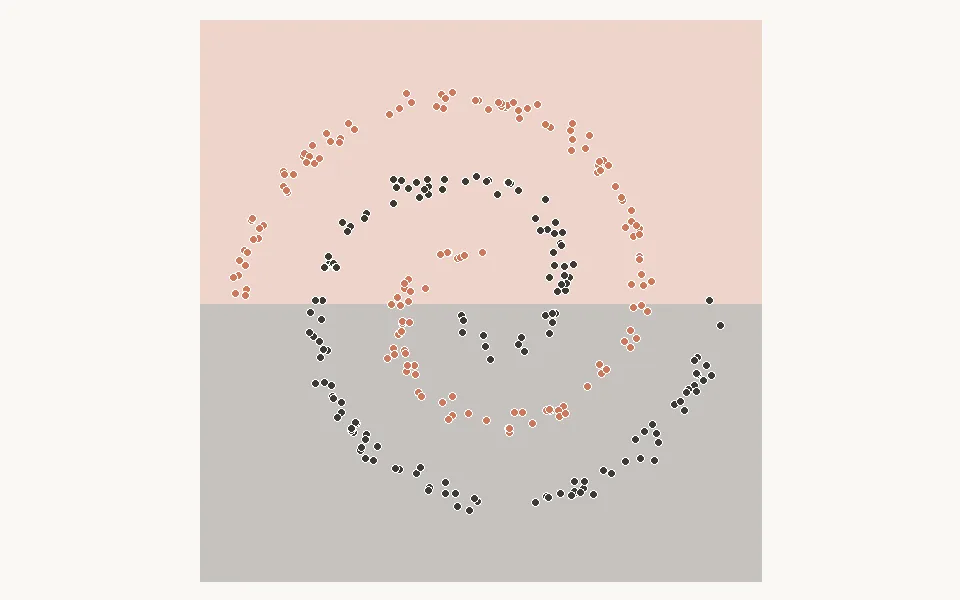
Todo lo de arriba, naranja; todo lo de abajo, gris. Acierta lo que cae en su lado por casualidad.
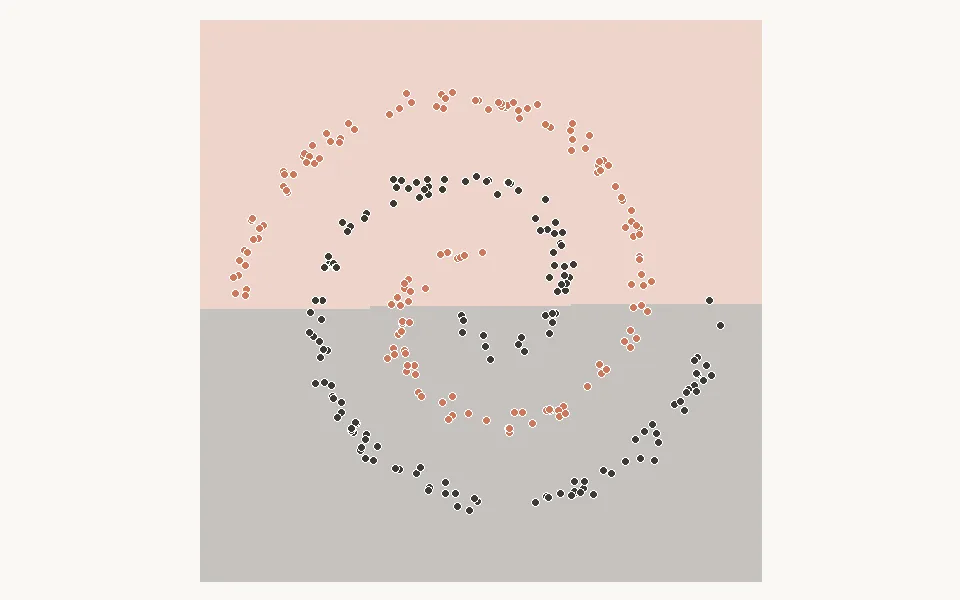
La frontera apenas se dobla. Ocho neuronas en una sola capa no dieron para más.
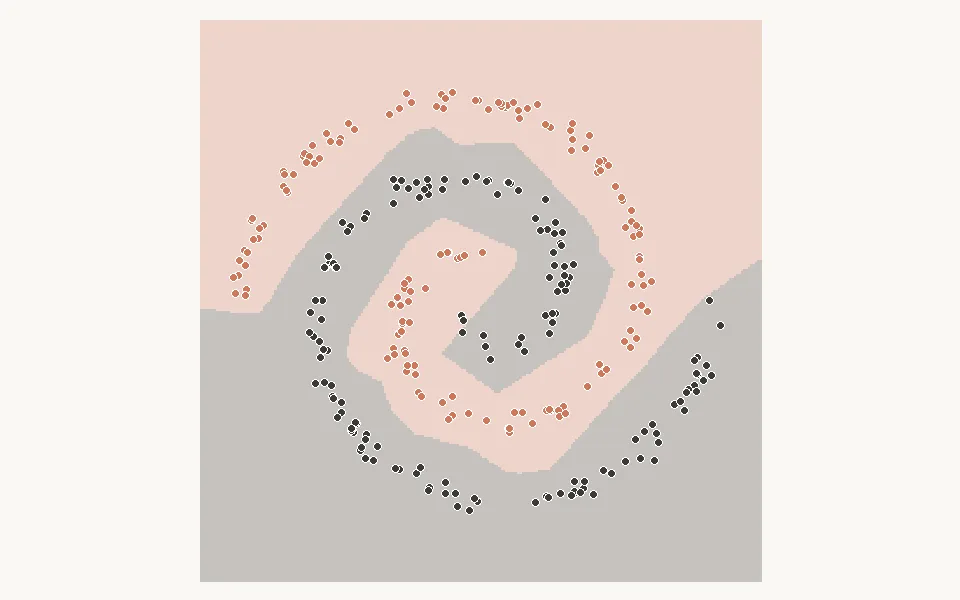
La frontera se enrosca con los datos. La encontró en 392 pasadas.
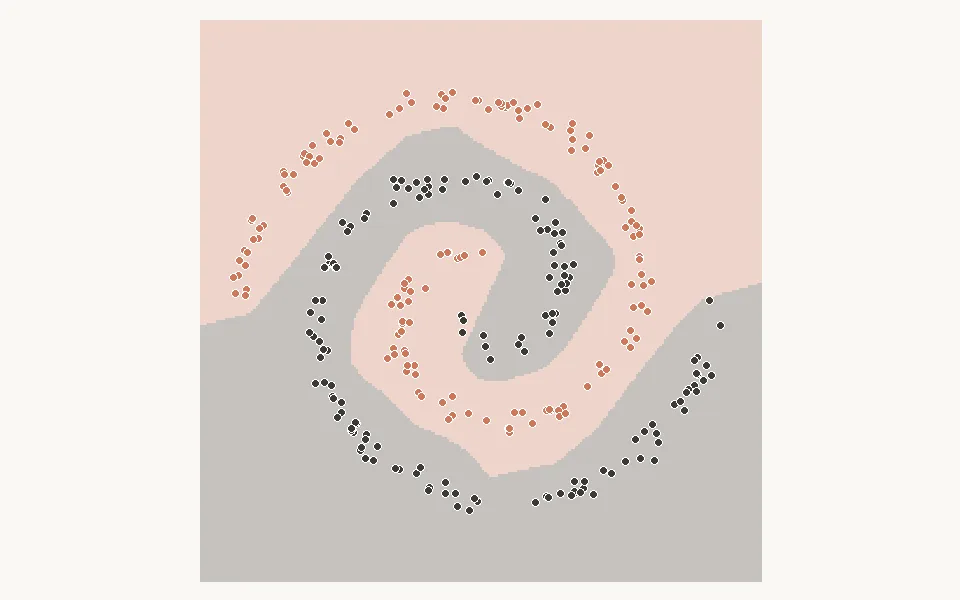
Mismo tamaño que la de tres capas y casi el mismo acierto, pero se detuvo tras 1.038 pasadas.
Mapas generados el 13 de noviembre de 2026 con scikit-learn en el servidor de este blog. Los puntos son los 300 de examen. El código de la prueba y los resultados se pueden descargar y repetir.
Capítulo 5 · La otra mitad de la prueba
Repetimos la comparación con un problema distinto: reconocer dígitos escritos a mano, del 0 al 9, en imágenes de 8×8 píxeles. Es un conjunto público de 1.797 imágenes que viene con scikit-learn3. Esta vez enfrentamos al modelo sin capas con una red de tres capas de 64 neuronas, dándoles cada vez más ejemplos y examinándolos con 540 imágenes que no habían visto2.
Muy pocos datos para aprender.
La distancia se acorta.
Todos los de entrenamiento.
Entonces, ¿para qué sirve? Para problemas en los que la forma de los datos es enrevesada y hay muchísimos ejemplos, como fotos, voz o texto. En un problema pequeño y sencillo como este, el modelo clásico es más rápido y más fácil de explicar, y aquí además acertó más.
Un matiz honesto: con 200 imágenes y con todas, la diferencia es de 8 y 6 aciertos sobre 540, en una sola ejecución. Da para decir que aquí la red no aportó nada, no que el modelo clásico sea siempre mejor. Si te ofrecen «deep learning» para un problema con pocos datos, pregunta por qué no basta un modelo clásico: puede bastar.
Capítulo 6 · Machine learning frente a deep learning
El deep learning es una parte del machine learning. En el artículo de qué es machine learning está el mapa completo, con los tipos de aprendizaje. Aquí van las diferencias que se notan en la práctica.
En el clásico, una persona elige las variables, como el importe o la hora de una compra. En el deep learning las descubren las capas. IBM llama al primer enfoque «ingeniería manual de características»1.
Tiene muchos más parámetros que ajustar, y para ajustarlos hacen falta ejemplos. En la prueba de dígitos, con 50 imágenes la red perdió por 4,4 puntos; con más datos, la distancia se acortó.
La red de tres capas de las espirales tardó 1,67 segundos; el modelo sin capas, 0,01: más de cien veces menos. Con millones de parámetros, esa diferencia se paga en tarjetas gráficas y en factura de luz.
Los 3 parámetros del modelo sin capas se leen a mano. Los 2.241 de la red, no. Por eso IBM recuerda que a estos modelos se les llama «cajas negras»1, un problema serio si hay que justificar una decisión, como negar un crédito.
Capítulo 7 · Ejemplos reales
La red de la prueba tenía 2.241 parámetros. AlexNet, la red de 2012 que, según su propio artículo, reconocía fotos «considerablemente mejor» que los mejores resultados previos, tenía 60 millones, repartidos en cinco capas convolucionales y tres totalmente conectadas4.
de parámetros tenía AlexNet en 2012, la red con la que el equipo de Geoffrey Hinton reconoció fotos de ImageNet mucho mejor que lo anterior4.
de estructuras de proteínas predichas por AlphaFold y abiertas a cualquiera en la base de datos de EMBL-EBI7.
El buscador de fotos del móvil que encuentra «playa» o «perro» sin que hayas etiquetado nada, el desbloqueo con la cara o la detección de matrículas.
Móvil · cámaras · diagnóstico por imagenTraductores automáticos, el corrector del teclado y los chats como ChatGPT. Estos últimos son redes enormes entrenadas con texto, y son la base de la IA generativa. Qué modelo rinde más se mide con pruebas públicas, como contamos en benchmarks de IA.
Chats · traductores · tecladosAlphaFold predice la forma de las proteínas. Por AlphaFold2, Demis Hassabis y John Jumper recibieron la mitad del Nobel de Química de 2024; la otra mitad fue para David Baker, por el diseño de proteínas6. Ese mismo año, el de Física fue para John Hopfield y Geoffrey Hinton por sus trabajos sobre redes neuronales artificiales5. Qué es real y qué es exageración en este campo lo separamos en IA y proteínas.
Biología · medicina · materialesEl dictado por voz, los subtítulos automáticos de los vídeos y los asistentes que entienden una orden hablada. Convertir sonido en texto es un problema enrevesado y con muchísimos ejemplos disponibles: justo donde una red profunda compensa lo que cuesta.
Dictado · subtítulos · asistentesCapítulo 8
Son tres círculos, uno dentro de otro. La inteligencia artificial es el campo entero: máquinas que hacen tareas que parecen inteligentes. El machine learning es la parte que aprende de ejemplos en lugar de seguir reglas escritas a mano. El deep learning es la parte del machine learning que usa redes neuronales de muchas capas.
Casi, pero no del todo. Las redes neuronales son la herramienta; el deep learning es usarlas con muchas capas ocultas. Una red de una sola capa es una red neuronal, pero no se considera profunda: IBM pone el listón en al menos cuatro capas.
Los tres que más se nombran son las redes convolucionales, pensadas para imágenes; las recurrentes, para secuencias como texto o audio; y los transformers, la arquitectura de los modelos de lenguaje actuales como ChatGPT. Hoy los transformers se usan también con imágenes y sonido.
El buscador de fotos del móvil, el desbloqueo facial, los traductores automáticos, los subtítulos automáticos de los vídeos, los chats como ChatGPT o Claude y AlphaFold, que predice la forma de las proteínas: por él, Demis Hassabis y John Jumper recibieron la mitad del Nobel de Química de 2024.
Para usarlo, nada: ya está dentro del móvil y de los chats de IA. Para entrenar un modelo propio hacen falta muchos datos etiquetados, tarjetas gráficas o servicios en la nube, y saber programar, normalmente en Python. Para un problema pequeño con pocos datos, suele ser mejor empezar con machine learning clásico.
load_digits: conjunto de dígitos escritos a mano (1.797 imágenes de 8×8 píxeles, 10 clases), copia del conjunto «Optical Recognition of Handwritten Digits» de UCI. scikit-learn.orgSigue leyendo